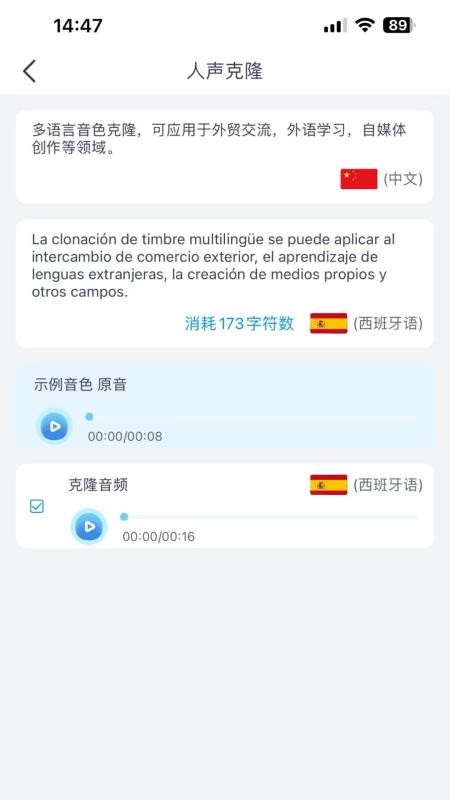
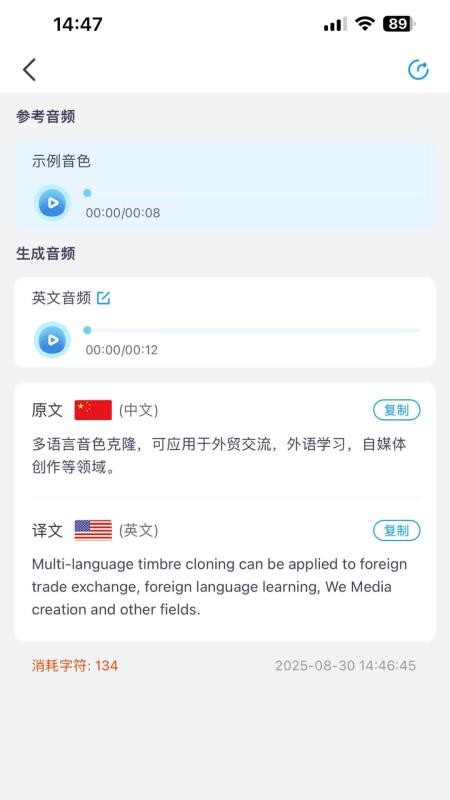
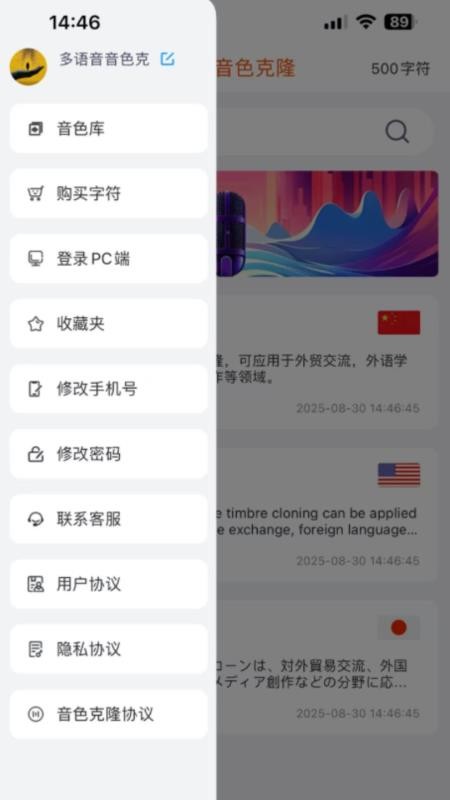
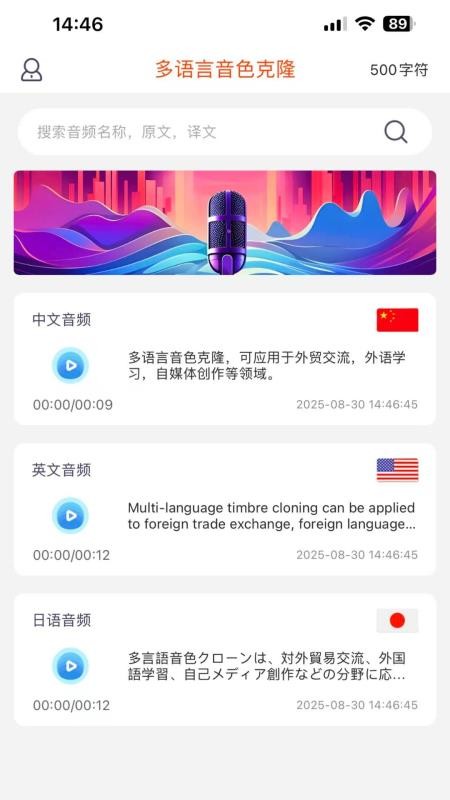
多语言音色克隆是一款基于先进人工智能技术的语音合成工具,它能够精准捕捉并复制用户的声音特征,在极短的时间内生成高度还原的音色模型。该软件支持多种语言和方言,广泛应用于有声书制作、视频配音、语音助手开发等场景。无论是个人创作者还是企业团队,都能通过简洁直观的操作界面快速完成音色克隆与调用,大幅提升内容生产效率,带来前所未有的语音创作体验。
多语言音色克隆由领先的AI实验室研发,运用深度神经网络与声纹分析技术,实现高精度的音色复刻。用户只需上传数十秒的录音样本,系统即可自动提取声音特征,构建个性化语音模型。该软件内置多语种引擎,支持中英日韩等多国语言合成,并允许调节语速、音调、情感等参数。无论是还原真人语音,还是创造虚拟角色,都能轻松胜任。同时,软件注重隐私保护,所有数据在本地加密处理,确保声音安全。简洁的界面与强大的API接口,让开发者能够快速集成,满足各类商业与个人需求。
高保真音色还原,细节丰富自然。
多语言支持,覆盖全球主要语种。
训练速度快,数十秒样本即可建模。
参数可调,灵活控制语速、音调与情感。
本地化处理,保障声音数据隐私安全。
云端与本地双引擎,离线也能使用。
实时合成,延迟低至百毫秒级。
支持声音混合,创造全新独特音色。
提供SDK,便于集成到第三方应用。
持续更新,不断优化多语言模型。
音色克隆:上传样本,一键生成专属音色。
文本转语音:输入文字即可获得自然语音。
多语言切换:自由切换不同语言进行合成。
语音调整:精细调节音调、语速与音量。
批量处理:一次性生成大量音频文件。
声纹特征提取:精准分析独特声音属性。
神经声码器:生成流畅连贯的语音波形。
多语种音素映射:实现跨语言声音保持。
情感合成引擎:赋予语音喜怒哀乐。
声音版权保护:内置水印与权限管理。
多语言音色克隆大大降低了语音制作门槛,让普通用户也能拥有专业级的声音克隆体验。其多语言能力尤其亮眼,为全球化内容创作提供了极大便利。在同类工具中,它在精度与易用性之间找到了出色平衡,是值得一试的AI语音利器。

 数字趣盒购物app更多其他点击查看
 小米系统桌面内测最新版更多其他点击查看
 鼾声分析器更多其他点击查看
 火山片场app最新版更多其他点击查看
 元壁纸软件更多其他点击查看
 河马输入法无广告版更多其他点击查看
 笔趣阁绿色版本更多其他点击查看
 SoundHound高级版更多其他点击查看
 红骑仕商城app更多其他点击查看
 EasyNotes更多其他点击查看
 智培盟更多其他点击查看
 银辉手游app更多其他点击查看
 书香之家app最新书源2026更多其他点击查看
 超级用户列表官方正版更多其他点击查看
 磁力种子播放器app更多其他点击查看
 wallpaper4K安卓版更多其他点击查看